Tekniset ratkaisut oikeuksien hallintaan tekoälyn koulutuksessa
Ajankohtainen haaste: teosten käyttö tekoälyn kouluttamisessa
Tekoälyn koulutukseen käytettyjen teosten ja datan oikeuksien hallintaratkaisut ovat nousseet merkittäväksi ja ajankohtaiseksi aiheeksi niin oikeudenhaltijoille kuin tekoälyn kehittäjille ja muille teknologiayhtiöille. Verkossa saatavilla olevan, tekijänoikeudellisesti suojatun sisällön hyödyntäminen vaatii uusia, luotettavia teknisiä ja oikeudellisia menetelmiä, joilla voidaan varmistaa aineistojen asianmukainen käyttö ja tekijänoikeuksien kunnioittaminen.
Tekijänoikeuden yhteishallinnointiorganisaatio Kopiosto ry käynnisti 1001 Lakes Oy:n kanssa syksyllä 2025 hankkeen, jonka tarkoituksena on kartoittaa markkinoilla olevia teknisiä ratkaisuja tekijänoikeuksien hallintaan tekoälyn kouluttamisessa. Alustavat tulokset ovat hyvin kiinnostavia.
Erilaisia rakennuspalikoita eri tarpeisiin
Tarjolla on useita erilaisia teknisiä välineitä, kuten tunnisteita ja standardeja, joiden pohjalta ratkaisuja erilaisiin oikeuksien hallinnan tarpeisiin voidaan rakentaa.
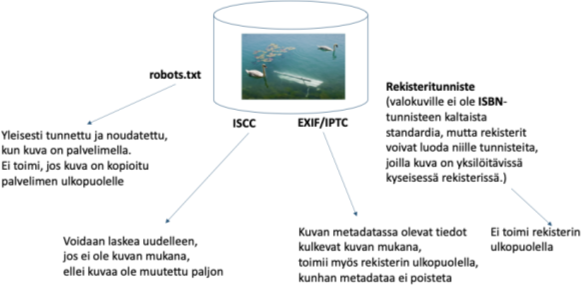
Yleisessä käytössä olevalla robots.txt-tiedostolla, voidaan ilmoittaa hakukoneille, tekoälyn kouluttajille ja muille nettiä haravoiville roboteille, mihin tarkoituksiin tämän sivuston tai palvelun sisältämiä tietoja saa hyödyntää.
On myös mahdollista liittää sisältöön sen oikeuksia kuvaavaa metadataa. Esimerkiksi digitaalisten valokuvien kuvatiedostoissa on usein EXIF (Exchangeable image file format) tai IPTC (International Press Telecommunication Council) -metatietostandardien mukaista kuvailutietoa, kuten kuvaan liittyviä aika- ja paikkatietoja sekä tekijänoikeudenhaltija- ja käyttöoikeustiedot.
Robots.txt ei kuitenkaan pakota noudattamaan käyttöehtoja eikä se seuraa mukana, jos yksittäinen sisältö kopioidaan muualle, ja metadata on helppo poistaa tiedostoista ja monet sosiaalisen median palvelut tekevät sen automaattisesti. Niinpä nämä yleisessä käytössä olevat tekniikat eivät ratkaise kaikkia oikeuksien hallintaan liittyviä ongelmia eikä oikeudenhaltija saa tahtoaan niillä aina riittävän hyvin ilmaistua.
Tunnistepohjainen sisältöhallinta
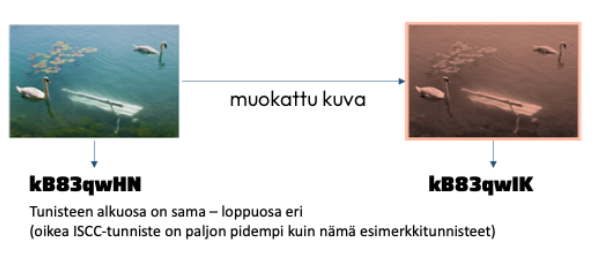
ISCC (International Standard Content Code) -tunniste edustaa lupaavaa teknistä ratkaisua digitaalisten aineistojen yksilöimiseen ja samankaltaisuuden arviointiin. ISCC on avoin, sisällöstä johdettu ja hajautettu tunnistejärjestelmä, joka on suunniteltu digitaalisen sisällön yksilöimiseen. Se on virallisesti hyväksytty kansainväliseksi standardiksi (ISO 24138).
ISCC-tunnisteen pohjana toimii kehittynyt hash- eli hajautusalgoritmi, joka mahdollistaa myös aineistojen sisältöperusteisen vertailun, kuten kuvien tai tekstien samankaltaisuuden tunnistamisen. Tekijänoikeudellinen arviointi jää edelleen viime kädessä ihmisasiantuntijan tehtäväksi, mutta ISCC-tunnisteella voidaan huomattavasti helpottaa ja nopeuttaa mahdollisesti samanlaisten teosten löytämistä automaattisesti.
Tekemiemme testien perusteella ISCC-tunnisteet ja niiden avulla laskettavat sisältöjen etäisyydet toisistaan (Content Distance) korreloivat hyvin aineistojen samankaltaisuuden kanssa ja auttavat tuomaan läpinäkyvyyttä jatkokäyttöön. ISCC-tunnisteen avulla voidaan luoda sisältöihin pysyviä viittauksia, jotka tukevat sekä tekijänoikeuksien hallintaa että koneellista tunnistusta.
TDM-AI ja käyttöehtojen automatisoitu tarkastus
TDM-AI on protokolla, joka mahdollistaa oikeudenhaltijoiden koneellisesti luettavien käyttöehtojen, kuten oikeuksien pidättämistä koskevien eli ns. opt-out-ilmoitusten – kyselyn järjestelmien välillä. TDM-AI antaa sisällöntuottajille mahdollisuuden ilmoittaa, saako heidän sisältöään käyttää tekoälyn koulutukseen. Se mahdollistaa myös muiden lisensointitietojen ilmoittamisen, ei pelkästään tekoälyn kouluttamisen tai tekstin- ja tiedonlouhinnan kieltoja.
TDM-AI-protokolla mahdollistaa rekisteripohjaisen tavan sitoa oikeuksien pidättämiset (opt-out) yksittäiseen sisältöön ISCC-tunnisteen avulla. Käytännössä tämä tarkoittaa, että tekoälyn kehittäjä voi selvittää, onko tietyn aineiston oikeudet tekstin- ja datanlouhintaan (TDM) tai tekoälyn kouluttamiseen pidätetty ja millä ehdoilla aineisto on käytettävissä näihin tarkoituksiin.
Standardoidut viitetunnisteet ja ONIX-integraatiot
Perinteisten tunnisteiden kuten ISBN:n (International Standard Book Number) lisäksi uudemmat standardit, kuten ISNI ja ONIX, tarjoavat mahdollisuuksia digitaalisten sisältöjen oikeudenhallintaan. ISNI (International Standard Name Identifier) on kansainvälinen, pysyvä ja yksilöivä tunniste, joka on tarkoitettu luovaa työtä tekevien henkilöiden ja yhteisöjen julkisten identiteettien tunnistamiseen. Se yksilöi tekijän tai organisaation, esimerkiksi kirjailijan, säveltäjän, kuvataiteilijan tai kustantajan 16-merkkisellä numerokoodilla. ISNI:tä käytetään laajasti kulttuurin, tieteen ja julkaisualan toimijoiden tunnistamiseen. Suomessa ISNI-rekisteröintitoimistona toimii Kansalliskirjasto.
ONIX (ONline Information eXchange) puolestaan on kansainvälinen XML-pohjainen standardi, jota käytetään kirja-alan tuotetiedon eli metadatan tallentamiseen ja välittämiseen sähköisessä muodossa. ONIXin tarkoitus on jakaa tietoa kirjoista, e-kirjoista ja muista julkaisuista kustantajilta jälleenmyyjille, kirjastoille, jakelijoille ja muille toimijoille yhdenmukaisessa muodossa.
ISNI ja ONIX-tunnisteiden avulla kustantajat voivat välittää yksilöityä tietoa teoksista ja niiden käyttöehdoista kansainvälisesti.
Yhteenveto ja tulevaisuuden kehitys
Tekniikan kehitys mahdollistaa entistä laajemmin oikeuksien automatisoidun hallinnan ja sisällön yksilöinnin. Yleisessä käytössä olevat ratkaisut, kuten robots.txt ja metadatastandardit antavat usein hyvän lähtökohdan oikeuksien hallintaan tekoälyn kouluttamisessa, mutta eivät yksin riitä. ISCC-tunniste ja TDM-AI-protokolla sekä standardoidut rekisterit tarjoavat oikeudenhaltijoille ja teknologiayrityksille kehittyneempiä työkaluja hallita tunnisteiden ja standardien avulla tekoälyn koulutukseen liittyvää aineiston käyttöä läpinäkyvästi, turvallisesti ja oikeudenmukaisesti.
Ensimmäiset kokeilumme osoittavat, että ratkaisut ovat jo varsin hyvin integroitavissa käytännön sovelluksiin. Jatkamme oikeudenhaltijoiden oikeuksien pidättämisen ja lisensoinnin ehtojen tarkastelun kokeilemista automaattisesti ISCC-tunnisteiden avulla omilla demo-ohjelmilla sekä olemassa olevien rekisterijärjestelmien avulla.
Kannen kuva: iStock / Prae_Studio